Interleaving (Echtzeitanwendungen)

How to Build a DASH Video Player.
Sobald die Leute zuhause sind und Netflix usw. schauen, kann ich Echtzeitanwendungen vergessen.
movie traffic (netflix) sieht so aus (DASH) Min.19:40 by Dave Täth @ UKNOF25 - Beating Bufferbloat with FQ_Codel.
Warum gehst du zurück zu FEC/Interleaving? Das ist ein versteckter buffer auf der letzten Meile. Siehst du hier für dein Thema: "Latenz / Paketverlust / buffer bloat" eine Ursache in der Kombination?
Auf meine Frage hat bisher niemand geantwortet :-( sehr schade!
FEC haben auf dein Problem keinen Einfluss.
Dem widerspreche ich mit meinem heutigen Kenntnisstand. Es kann sein, dass FEC (Layer 1/2 auf der letzen DSL-Meile) die Ursache dieses Problems ist. Widerrufst du die Aussage in #2 "Bufferbloat ist meines Erachtens das Problem in der IT, das mit Abstand am deutlichsten überbewertet wird."? Wie wirkt DOCSIS-Protokoll mit FEC und Interleaving für TCP/IP auf DSL/KoaxKabel-Leitungen auf die Latenz?

Dave Täth war so freundlich und gab mir heute die Anwort im Video vor 12 Jahren. Es folgt eine Frage zu DSL. Dave's Antwort beschreibt genau die Ursache des Problems "DSL has these Binary BLOBs at the last stage ... an unknown or sometimes an excessive amount of buffering" und zeigt die Lösung "This stuff has to move in, very very very close to the hardware."
BLOB = Binary Large Object

Gehen wir nochmal zurück zu #243 es geht um FEC und Interleaving.
Damit bist du bei der Bitübertragung (Layer 1) bzw. der Sicherungsschicht (Layer 2), sog. Data Link Layer. Es wird Zeitverzögerung [ms] (Retransmisson von Frames) gegen "echten" Paketverlust (auf Layer 3 Vermittlung / 4 Transport) getauscht.

Result: Reduced packet loss, but increased latency, often up to 40ms.

@Zuckersüß Du schraubst an den richtigen Dingen. Was ich dabei vermisse ist, es systematisch in Kombination und mit logischem Verständnis zu tun.
Ich habe die letzten 24 Stunden alles mögliche getestet und auch mehrfach verifiziert und bin mir sicher, dass Problem gefunden zu haben.

Ich glaube auch nicht, dass der ISP was dran ändern kann. Aber nicht, weil die Infrastruktur der Telekom gehört, sondern weil die Ursache für deine Probleme außerhalb deines Zugangsnetzes liegt.
außerhalb deines Zugangsnetzes = dazwischen

Vielleicht verwendet der ISP bzw. die Wohnungsgesellschaft im Wohnviertel benachteiligende Hardware, bis es ins beste Netz der Telekom geht, deshalb empfehle ich prmär den Umzug.

Bist du ein Technikstudent der spielt oder bist du ein obsessiver Computerspielesüchtiger? Achtung: Gaming Disorder ist eine von der WHO anerkannte psychische Krankheit. In diesem Fall empfehle ich einen Arzt- oder Psychotherapeutenbesuch. Bist du der spielende Student der Nachrichtentechnik, empfehle ich akzeptiere dass FEC/CRC keine Fehler sind und gehe zurück zu #226 der "Interleave Depth" (Rechenaufwand/Leitungsfehler), verwende einen Router mit OpenWRT, verwende zum ISP mit DOCSIS eine geringe Interleaving Depth (geringere Bandbreite zugunsten schnellerer Latenz) fest eingestellt. Du möchtest 60 Pakete pro Sekunde in korrekter Reihenfolge, das sind 1000/60ms. Hilft das alles nichts, teile deine Kenntnisse und Erkenntnisse bzgl. Latenz und bufferbloat deinem Immobilienunternehmen (ISP) mit, frage ob die Technik aktuelle Queing Mechnismen in DOCSIS, z.B. Low Latency DOCSIS (LLD) einsetzt. Minute 22:40 The code is out there, man go forth and test. It's free. come on.
Warum die Ursache eher in unserem Gebiet liegt?
Folge der Empfehlung: Bereite deinen Umzug vor. Das Immobilienunternehmen Vonovia.com und Synvia.de maximieren die Bandbreite und ihren Gewinn, vergessen dabei evtl. die Latenz zu minimieren. Mit den Worten von Dave Täht: "At the last stage" "This stuff has to move in, very very very close to the hardware."
 
Zuletzt bearbeitet:
  • Like
Reaktionen: Peter_Lehmann
Hallo.

Ich kann hier nicht umziehen. Ich wohne erst seit 1 Jahr hier und dieser Umzug hat mich 100K Euro gekostet (alles neu auf diese Wohnung abgestimmt gekauft). Allein die maßgeschneiderte Küche hat mich über 30K gekostet.

Auf DOCSIS (Vodafone) kann ich hier nicht setzen, weil es hier mehrere Störer gibt und Vodafone diese nicht beseitigen will oder kann. Zudem ist das Segment gnadenlos überbucht. Ich habe hier ein Docsis-Router von einem Bekannten angeschlossen und es hat auch sofort funktioniert, aber der Upload ist massiv gestört. Mein direkter Nachbar (Tür an Tür) erzählt mir, dass der Techniker (Vodafone) meinte, dass hier JEDER betroffen wäre, aber die wenigsten es bemerken würden.

Ich bin Softwareentwickler, der in seiner Freizeit gerne spielt. :)

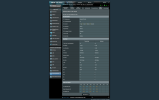
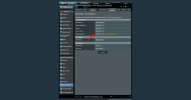
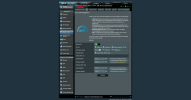
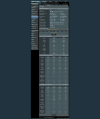
Meine aktuellen Settings:

1.png 2.png 3.png 4.png

Mein Router kann mit der Custom-Firmware CAKE und ob sich ein neues Gerät lohnt, weiss ich nicht genau, wenn ich doch bald FTTH bekomme.

Ich habe ein Packet Loss Test Run (60 Pakete / ~220 Byte pro Paket / 180 Sekunden) von einer KI prüfen lassen und die KI fand das Ergebnis seltsam. Die Pakete würden wie in Wellen reinkommen, aber ich kam bisher nicht dazu, dass ganze intensiv zu untersuchen.
 
Bufferbloat ist meines Erachtens das Problem in der IT,
dass mit Abstand am deutlichsten überbewertet wird.
Dazu stehe ich nach wie vor. Was nicht bedeutet, dass es nicht vorkommen kann. Im Thread, wo das Zitat fiel, gab es kein Bufferbloat Problem, und viele neigen dazu, es für alles und jedes Fehlverhalten verantwortlich zu machen, und dabei den Fokus aus den Augen zu verlieren.

Woraus schließt du das?
Aus den Messungen, die hier im Laufe des Threads gezeigt wurden. Die lassen keinen anderen Schluss zu. Die Einflüsse aus dem Interleaving konnten schon theoretisch nicht die Größenordnung erreichen, um die es ging. Die Messungen hingegen zeigen deutliche Ausschläge bei verhältnismäßig kleinen Bandbreiten. Um ehrlich zu sein, wundert mich nur, dass hier so lange über DSL Parameter diskutiert wurde, aber niemand aufs Peering und die darauf resultierenden Probleme zu sprechen kam. Dort und auf Applikationsebene liegt das Problem.
 
aber niemand aufs Peering und die darauf resultierenden Probleme zu sprechen kam
Auf die Probleme beim Peering wurde aber bereits schon in #138 hingewiesen.
 
Das es am Interleaving, INP, G.INP oder den FEC liegt, glaube ich mittlerweile auch nicht mehr.

Ich kann mich via SSH auf meinen Router anmelden und dort viel mehr Informationen auslesen, als mir die Oberfläche anzeigt.

Beispiel:

~20 Stunden seit Neustart des Routers

ParameterDownstreamUpstreamBedeutung
rtx_tx10.0294.973Neu gesendete Pakete
rtx_c2.1684.515Korrigierte Retransmissionen
rtx_uc00Unkorrigierte Retransmissionen

ParameterDownstreamUpstreamEinheitErklärung
INP62.0034.00SymboleSchutz gegen Impulsstörungen (mit G.INP realisiert). Werte über 50 gelten als sehr hoch.
INPRein1.001.00–Re-Initialisierungs-Impulsschutz nach Störpausen.
delay00msInterleave-Verzögerung (0 ms = Fastpath / kein Interleaving). Ideal für Echtzeitanwendungen.
PER0.000.00%Paketfehlerrate auf DSL-Ebene. 0 % bedeutet keine verwertbaren Paketverluste.
OR0.010.01%Auslastungsreserve (Overhead Rate) – praktisch vernachlässigbar.
AgR231'859.3946'959.32KbpsTatsächliche Netto-Datenrate (etwas höher als die Basis-Sync-Rate durch G.INP-Overhead).

Ich habe alles mögliche auf Modem- und Router-Ebene geprüft. Es sieht alles sauber aus. Meine Echtzeitanwendung ist "als QOS" eingerichtet und die Pakete werden auch vom Router richtig erkannt. Der Puffer bleibt schön leer.

Alles sieht super aus und trotzdem habe ich Probleme mit den Paketen die ankommen und rausgehen, weil etwas außerhalb meines Einflussbereiches das ganze stört. Dazu reicht ja schon Jitter.

Zum INP und FEC: Wenn mein FEC-Counter nicht rasend nach oben knallt und ich das über mehrere Tage laufen lasse, dann sinkt auch der INP auf bis zu 30:30 bzw. 30:29. Rast der FEC-Counter wie von sinnen nach oben (was bei ~6dB SNR passiert***), dann reagiert das System mit einer starken erhöhung des INP darauf. Das ist meine Beobachtung. Ein hoher INP ist auch nichts gutes, sondern die logische Reaktion auf ein Problem.

*** Ich korrigiere die SNR mit +6dB manuell nach oben um auf ca. 12dB zu kommen.
 
  • Like
Reaktionen: Ldwg2002
@Zuckersüß Wurde eigentlich für die Echtzeitanwendung auch schon einmal testweise ein anderer Serverstandort, beispielsweise Amsterdam, ausgewählt? Nur so ein Gedanke, auf welchen ich beim Lesen des folgenden Post gekommen bin.
 
Für Europa gibt es nur den Server in Frankfurt. Der nächste Server befindert sich in den USA und da läuft das ganze noch viel schlimmer für mich.

Problem ist unverändert: Zu bestimmten Tageszeiten und an Wochenenden/Feiertagen ist es praktisch dauerhaft da.
 
@Zuckersüß Ich habe nachgelesen was ein Softwareentwickler heutzutage tut/kann. Demnach bezeichne ich mich als Full-Stack-Stümper, weil ich Programmieren nie als Beruf gelernt habe und bisher durchgängig (Frontend, Backend) stümpern durfte, anfangs beruflich, später als Hobby. Dein Asus/Merlin tut was er soll. Dennoch, ein OpenWRT-Router kostet kein Vermögen, z.B. gibt es eine 7490 günstig, die OpenWRT-Firmware flashen kannst du als Softwareentwickler._FrontEnd_dygraphs.jpg

wundert mich nur, dass hier so lange ... diskutiert wurde,
dito. Danke für deine Erklärungen. Die Größenordnung der Einflüsse aus dem Interleaving sehe ich als Treppenstufen in smokeping. Und mir geht es mit Peering so.
Peering ist meines Erachtens ein Problem in der IT,
das derzeit mit Abstand am deutlichsten überbewertet wird.
Um in der IT (bei multiplen Möglichkeiten) das eine vom anderen verlässlich zu unterscheiden Bedarf es umfangreicher belastbarer Tests (Ausschlussverfahren).

@tango501 Seit #9 (mit einigen Links) habe ich einige gameserver in USA (Nordamerika) im smokeping-Monitoring. Aus einer seit Monaten kontinuierlich (ohne Tageszeitschwankung) stabilen RTT von ca. 100ms mit packet loss zw. 0,0% und 0,2% kann ich nichts, rein gar nichts in Richtung "peering policy" ableiten. "Typische Werte (z.B. Frankfurt – New York/Ostküste): Die RTT liegt meistens im Bereich von 70 bis 110 Millisekunden (ms)."
Was ich immer bestätigen kann ist eine miserable RTT mit PL im ein- bis zu zweistelligen Prozentbereich zwischen einzelnen Verbraucheranschlüssen untereinander. Bevor man hier Alarm schlägt, vergewissert man sich, dass man kein DNS/dynDNS-Problem hat, z.B. Monitoring auf die IP-Adresse.

Köln ist keine Landeshauptstadt Die Landeshauptstädte sind: Stuttgart (BW), München (BY), Berlin (BE), Potsdam (BB), Bremen (HB), Hamburg (HH), Wiesbaden (HE), Schwerin (MV), Hannover (NI), Düsseldorf (NW), Mainz (RP), Saarbrücken (SL), Dresden (SN), Magdeburg (ST), Kiel (SH), Erfurt (TH). @Zuckersüß, in einer Landeshauptstadt, hat keine Alternative.

Jede vorgeschlagene Alternative hast du, Zuckersüß, begründet abgelehnt
#280, inkl. einem Umzug. Weil sich niemand auskennt bzw. zuständig ist (Vonovia oder Synvia), dein Hausmeister ist genervt und vertröstet dich auf FTTH, "der Techniker (Vodafone) meinte, dass hier JEDER betroffen wäre, aber die wenigsten es bemerken würden" #282, ist deine einzige Möglichkeit etwas in Richtung Besserung anzuschieben, ein Vorgehen wie bereits von mir in #142 skizziert.

Ich verstehe nicht, was einen Softwareentwickler davon abhält ein Linux mit smokeping (Reading the Graphs) aufzusetzen, einige Wochen laufen lassen, damit eklatante Paketverluste (im Prozentbereich, tagesabhängig) zu dokumentieren. Daraus wird eine Beschwerde bei deinem Vertragspartner formuliert und objektiv belegt. Zeitgleich platzierst du "das Problem mit deinem Vertragspartner (Vonovia bzw. Synvia)" bei der BNetzA, denn dort gibt es per Definition keinen Paketverlust auf Layer 3 (Überlast) im TCP/IP-Netz (in deinem Internet). Dir muss es egal sein ob die Ursache für die Unmöglichkeit (§ 275 BGB) dazwischen, dahinter, mittendrin oder außerhalb liegt. Der BNetzA darf ein Verstoß gegen die TKMV nicht gleichgültig sein, egal ob die Ursache eine "peering policy" ist oder das "queuing auf einem (überlasteten) Netzabschnitt" (was letztlich ein und dassselbe ist) oder etwas ganz anderes. Ein für dich zu langsamer ping/ICMP <150ms interessiert die BNetzA hingegen überhaupt nicht. Steht alles in etwa so in #142.

Ich wundere mich nur, dass hier jeder über eine konkrete Ursache in einem Netzteil fabuliert den niemand einsehen, geschweige denn beeinflussen kann. Die Ursache findet/n d/ein/e Netzbetreiber schon selbst, aber du musst deinem Vertragspartner die Auswirkung nachweisen, wenn die TKMV gerissen wird ggfs. der BNetzA mitteilen, um Nachdruck zu erzeugen.

Da dieser allerletzte Vorschlag keine Alternative für dich sein wird und du dafür eine Begründung findest, dass dieses Vorgehen nichts bringt, noch m/eine ultima ratio: Such' dir ein anderes Hobby.
 
Zuletzt bearbeitet:
Ich verstehe nicht, was einen Softwareentwickler davon abhält ein Linux mit smokeping (Reading the Graphs) aufzusetzen, einige Wochen laufen lassen, damit eklatante Paketverluste (im Prozentbereich, tagesabhängig) zu dokumentieren. Daraus wird eine Beschwerde bei deinem Vertragspartner formuliert und objektiv belegt.
Nein. Pings (ICMP Pakete) haben ein anderes Protokoll, ein anderes Ziel und werden in Router anders behandelt und ggf. sogar anders geroutet. Es ist ein Hinweis, mehr nicht, aber niemals ein objektiver Beleg, der sich als Grundlage für eine Beschwerde eignet. Zumal in Deutschland lediglich die Geschwindigkeit Vertragsbestandteil ist und seitens der Bundesnetzagentur auch als Kriterium für eine Beschwerde akzeptiert wird. Weder Latenz noch Paketverluste spielen dort eine Rolle.
 
Du kannst dir ja mal den Spaß machen und dir die Mindestanforderungen für Internetanschlüsse in Deutschland anzusehen, die die BNetzA auf Basis des TKG festlegt und die Passagen in Bezug auf Latenz und Paketverluste zitieren, was da von deiner Beschwerde übrig bleibt. Spoiler: Dieser Fall hier erfüllt die Anforderungen.
 
Zumal in Deutschland lediglich die Geschwindigkeit Vertragsbestandteil ist und seitens der Bundesnetzagentur auch als Kriterium für eine Beschwerde akzeptiert wird. Weder Latenz noch Paketverluste spielen dort eine Rolle.
Wenigstens frank_m24 hat die mehrfach dargebotenen Links inzwischen gelesen und beginnt allmählich zu verstehen.
bei der BNetzA, denn dort gibt es per Definition keinen Paketverlust auf Layer 3 (Überlast) im TCP/IP-Netz (in deinem Internet).
Die Latenz, also die Reaktionszeit, darf nicht höher als 150 Millisekunden sein.
und frank_m24 hat die Messungen auch schon durchgeführt.
Spoiler: Dieser Fall hier erfüllt die Anforderungen.
Diesen Widerspruch kann ich nicht auflösen.
was da von deiner Beschwerde übrig bleibt.
Bei mir waren die Anforderungen erfüllt. Aber nach meinen Tickets beim Netzbetreiber blieb keine Störung mehr übrig, also auch kein Beschwerdegrund, leider. Übrig bzw. zurück blieben nur meine dokumentierenden Beiträge hier im IPPF. Übrigens wurden Messungen (24/7 aka Monitoring) mit smokeping bzw. PingInfoView/Nirsoft durchgeführt. Für meinen Netzbetreiber taugte das als Hinweis. Die Fehlerursache wollte der beste Netzbetreiber mit seinen qualifizierten Technikern schon gerne selbst herausfinden. Full-Stack-Stümper wie ich können das eh nicht. Andere Endverbraucher können (Softwareentwickler z.B. wollen) kein Monitoring, die messen dann nach Anforderungen der BNetzA, um einen "objektiven" Hinweis auf eine "tatsächliche" Störung zu haben, damit der Netzbetreiber seine Techniker schickt.
[IRONIE]
Egal, versuchen wir uns hier weiter mit der technischen Problemanalyse. Im LAN oder im Zugangsnetz der Synvia.de oder im besten Netz der Telekom. Derzeit im Rennen. Wer hat noch weitere Ideen oder Vorschläge?
peering policy / Layer 3​
interleaving / Layer 1+2​
bufferbloat / Layer 3+4 Korrigenda frank_m24 #295 und tlw. 1+2 Dave Täht #281​
FEC (Forward Error Correction) und G.INP (Impulse Noise Protection) / Layer 1+2​
Und der Hausmeister (facility manager) der Vonovia.com möchte bitte für Abhilfe sorgen.
[/IRONIE]

[EDIT Ergänzung: meine einzige These (Einzahl) / wegen Novize #294]

Techniker der beteiligten Netzbetreiber können eine Störung beheben. Eine genaue Fehlerursache brauchen die Techniker nicht, das ist deren Kompetenz.

So meint das auch 3CX, der größte Sponsor (oder Betreiber) des IPPF.

Tageszeitabhängige hohe Latenzen/Ausfälle @ 3cx.de Mein Ping ist schlecht
Die Gründe hierfür liegen typischerweise in Überlast-Situationen (siehe den vorigen Punkt) im eigenen LAN (z.B. durch P2P-Anwendungen/Filesharing) oder beim ISP, die tageszeitabhängig auftreten (z.B. am Morgen bei Arbeitsbeginn, zur Mittagszeit, am Abend nach Feierabend).​
Tritt der Effekt eines geringen schlechten Ping regelmäßig auf und ist nicht im eigenen LAN/Router begründet, so ist der ISP zu verständigen.​

Ende der These (eine Selbstverständlichkeit). Damit ist das Thema "Interleaving (Echtzeitanwendungen)" (für mich) final erledigt. Spannend bleibt es dennoch QoS - Quality of Service (VoIP) - Sizing Router Buffers - Small is the New Big, 2023, Sharada Yeluri "Understanding Round-Trip-Time (RTT) is critical for buffer sizing and for developing congestion control algorithms."

Wie viele "Störungen" schlagen beim Support eines Netzbetreibers auf? Davon haben wie viele ihre Ursache im lokalen LAN/WLAN und der Techniker rückt unnütz aus?

Aufgrund des eigenen Monitorings war ich mir bei Störungen sicher, dass ein "qualifizierter Techniker" eine Fehlerursache außerhalb des LAN's finden muss. Vor Ort hatte ich bisher nur "qualifizierte Techniker" vom besten ISP, die sich zu Diagnosezwecken auch mal für das Argument "lokales 24/7-Monitoring" interessierten, nicht der Ticket-Support. Eine Ursache für die Störung wurde immer gefunden, keine Ausreden, keine Kosten für Technikerbesuch, Störung behoben. Mit Überlast oder unerfahrenen Technikern hatte ich bisher keinen Kontakt, sonst wäre irgendwann die BNetzA ins Spiel gekommen. Dauerhaft widerkehrende tagszeitabhängige hohe Latenzen/Ausfälle können z.B. durch Änderung des Routings oder durch Netzausbau behoben werden.

Du hast bis jetzt nicht verstanden, was frank_m24 hier schrieb.
So wird es sein. Akustik (nuschelt frank_m24?) oder ist es die Komplexität seines Satzbaus oder des Themas, das mich überfordert? Hast du verstanden was er schrieb? Kannst du es mir erklären, bitte?
[/EDIT]
 
Zuletzt bearbeitet:
Wenigstens frank_m24 [...] beginnt allmählich zu verstehen.
Mit Verlaub, Du hast bis jetzt nicht verstanden, was frank_m24 hier schrieb. Du versteifst Dich auf Deine Thesen und versuchst auf Biegen und Brechen diese bestätigt zu sehen. Das das aber teils nur mit arg konstruierten Teilaspekten klappt, ist Dein gesamtes Thesenkonstrukt doch sehr wackelig.
Da aber Deinen "Lieblings-Sparingspartner" so anzugehen, ist hier nicht erwünscht. Bleibe sachlich und ausschließlich(!) beim Thema.
Persönliche Übergriffe trage mit deinen Kumpels am Stammtisch aus, nicht hier!
 
  • Like
Reaktionen: Ldwg2002
Problem ist unverändert: Zu bestimmten Tageszeiten und an Wochenenden/Feiertagen ist es praktisch dauerhaft da.
Dazu noch ein aktueller Beitrag mit einer möglichen Problemursache.
 
  • Like
Reaktionen: Zuckersüß
Ein Telekom Mitarbeiter meinte zu mir, dass die Leitung hier - unmöglich - ausgelastet werden könnte und trotzdem erlebe ich diese Probleme Tag für Tag (Prime-Time, Fr-So und an Feiertagen).

Ich setze jetzt alles auf den FTTH-Anschluss. Wenn das auch ein Flop wird, dann weiss ich auch nicht mehr.
 
Ein Telekom Mitarbeiter meinte zu mir, dass die Leitung hier - unmöglich - ausgelastet werden könnte
Das ist ja auch nicht dein Problem.

Wenn der FTTH Anschluss über die Telekom kommt, ist die Infrastruktur und damit das Peering identisch. Das wird dann am Ende keinen spürbaren Unterschied machen.
 
Die Aussage des Telekom-Mitarbeiters bezog sich auf VDSL.

Telekom sagt: Leitung kann nicht ausgelastet werden
Ich sage: Ich spüre täglich eine Auslastung (ich kann die Uhr danach stellen)
 
Das hat aber mit der Leitung nichts zu tun. Bei FTTH wäre es genauso wie bei VDSL. Wie oft muss dir das noch gesagt werden?
 
Kostenlos!

Statistik des Forums

Themen
248,986
Beiträge
2,308,009
Mitglieder
378,770
Neuestes Mitglied
pinguin2001